De Figma au code avec l'IA : ce qui marche, ce qui casse
Une IA reliée à Figma peut écrire le code d'un écran en quelques minutes. Le résultat dépend presque entièrement du fichier qu'on lui donne. Voici ce que je prépare avant, ce que je lui confie sans crainte, et les erreurs que je cherche systématiquement après.
L'IA lit la structure, pas l'image
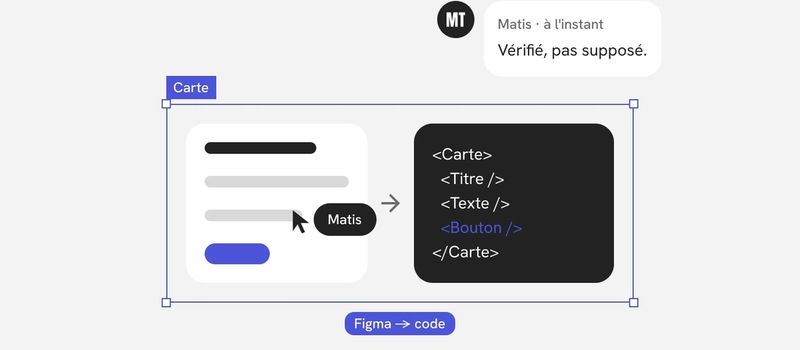
C'est le point de départ de tout le reste. Quand l'IA lit un fichier Figma, elle ne regarde pas l'écran comme un humain. Elle lit ce qui le compose : des calques, leurs noms, leurs propriétés, les variables et les composants qu'ils utilisent.
Un fichier bien construit lui dit donc exactement quoi écrire. Un fichier mal construit lui laisse deviner. Et quand elle devine, elle produit quelque chose de plausible, pas quelque chose de juste.
Autrement dit, le passage au code commence dans Figma, bien avant la première ligne générée.
Les quatre prérequis côté fichier
Je ne lance aucune traduction tant que ces quatre points ne sont pas tenus.
1. Des variables pour chaque valeur
Chaque couleur, chaque taille de texte, chaque espacement, chaque arrondi passe par une variable. Une couleur saisie à la main arrive dans le code comme une valeur isolée, que personne ne reliera jamais au reste du système.
Avec des variables, l'IA n'écrit pas une valeur : elle écrit une référence. Si le fichier dit « texte secondaire », le code dit « texte secondaire ». Et un changement de valeur se fait ensuite à un seul endroit, des deux côtés.
2. Des composants pour chaque élément répété
Un bouton dessiné dix fois donne dix boutons dans le code, légèrement différents. Un bouton construit comme un composant, avec ses variantes et ses propriétés, donne un seul composant appelé dix fois.
Les propriétés comptent autant que le composant lui-même. Une propriété « taille » avec les valeurs « petit » et « grand » devient un paramètre du composant dans le code. C'est la traduction la plus fiable qui soit, parce qu'il n'y a rien à interpréter.
3. De l'Auto Layout partout
Sans Auto Layout, un écran n'est qu'une collection d'éléments placés à des coordonnées. L'IA reproduit alors ces coordonnées, et l'interface se casse dès que la largeur change ou qu'un texte s'allonge.
Avec l'Auto Layout, le fichier décrit une intention : ces éléments s'empilent, cet espace est constant, ce bloc prend toute la largeur disponible. C'est exactement ce que le code a besoin de savoir pour s'adapter.
4. Des noms qui veulent dire quelque chose
« Frame 427 » ou « Rectangle 12 » ne disent rien à l'IA. « Carte projet », « En-tête », « Liste des articles » lui donnent à la fois la fonction de l'élément et le nom du composant à écrire.
J'aligne ces noms sur le vocabulaire du code dès que c'est possible. Deux vocabulaires différents finissent toujours par produire deux versions du produit.
Ce que l'IA fait bien
Sur un fichier qui respecte ces quatre prérequis, l'IA est très efficace sur ce qui est long et mécanique :
- poser les fondations : transformer les variables du fichier en variables de code, avec les mêmes noms et les mêmes modes, clair et sombre, mobile et ordinateur ;
- écrire les composants simples avec leurs variantes, à partir des propriétés déclarées dans Figma ;
- assembler un écran à partir de composants qui existent déjà, sans les réécrire ;
- reproduire la mise en page décrite par l'Auto Layout, avec les bons espacements et les bons alignements ;
- appliquer un changement partout, quand une variable ou un composant évolue.
Ce sont précisément les tâches où un humain finit par prendre des raccourcis. L'IA, elle, n'en prend pas, à condition que la règle soit écrite quelque part.
Ce qui casse
Même sur un fichier propre, certaines erreurs reviennent. Je les connais, donc je les cherche.
Les valeurs inventées. Dès qu'un élément échappe aux variables, l'IA comble le trou avec une valeur proche. Un gris presque identique, un espacement de quelques pixels différent. À l'œil, rien ne se voit. Dans le code, le système vient de perdre sa cohérence.
Les états qui n'existent pas. Si le survol, la désactivation ou l'erreur ne sont pas dessinés, l'IA les invente ou les oublie. Dans les deux cas, c'est une décision de design prise sans moi.
Les composants en double. Plutôt que de réutiliser un composant déjà présent dans le code, l'IA en écrit parfois un nouveau, presque pareil. Au bout de quelques écrans, il y a trois cartes au lieu d'une.
La mauvaise nature des éléments. Un rectangle cliquable dans Figma peut devenir un simple bloc dans le code au lieu d'un vrai bouton ou d'un vrai lien. Il s'affiche correctement, mais il n'est ni utilisable au clavier ni compris par un lecteur d'écran.
Le comportement entre deux tailles. Le fichier montre souvent une version mobile et une version ordinateur. Ce qui se passe entre les deux n'est dessiné nulle part. L'IA extrapole, parfois bien, parfois non.
Les textes et les contenus réels. Une maquette montre un titre de trois mots. Le vrai contenu en fait douze, ou il manque. Si ces cas limites ne sont pas décrits, le code ne les gère pas.
Le point commun de toutes ces erreurs : elles apparaissent là où le fichier se tait. D'où ma règle, déjà évoquée dans mon article sur l'IA dans mon travail : rien n'est déduit en silence. Ce qui manque devient une question, pas une supposition.
Comment je vérifie
Je ne juge jamais le résultat sur la parole de l'IA, ni sur un coup d'œil. Je vérifie sur pièces, en cinq contrôles.
- La comparaison côte à côte. Une capture de l'écran codé à côté de la maquette, aux mêmes largeurs. Je regarde les espacements, les tailles de texte, les alignements. Les écarts de quelques pixels sont précisément ceux qu'on ne remarque pas sans comparer.
- La recherche des valeurs isolées. Je fais chercher dans le code toutes les couleurs et les tailles écrites en dur, hors variables. Chaque occurrence est soit une erreur, soit une variable qui manque dans le fichier.
- Le passage des états. Je parcours chaque composant dans tous ses états : survol, focus, désactivé, erreur, vide, chargement. Tout ce qui n'était pas prévu apparaît ici.
- L'étirement. Je fais varier la largeur de la fenêtre en continu, et je remplace les textes par des versions très longues et très courtes. Un écran qui tient à deux largeurs précises ne tient pas forcément entre les deux.
- L'accessibilité et la performance. Des seuils automatiques, vérifiés à chaque modification. Navigation au clavier, contrastes, nature des éléments, poids de la page.
Les deux derniers contrôles sont ceux que j'automatise en premier. Ils ne se fatiguent pas, et ils ne font pas d'exception.
Mes règles de travail
Au-delà des contrôles, quelques règles simples évitent la plupart des problèmes.
- Un composant avant l'écran. Je fais traduire et valider un premier composant avant de lancer un écran entier. Si le composant est faux, tout ce qui l'utilise le sera aussi.
- Un écran avant les autres. Même logique à l'échelle supérieure. Le premier écran révèle les défauts du fichier, que je corrige dans Figma avant de continuer.
- Corriger à la source. Quand une erreur vient du fichier, je la corrige dans le fichier, pas seulement dans le code. Sinon, elle reviendra à la prochaine traduction.
- Nommer les composants existants. Je donne à l'IA la liste des composants déjà présents dans le code, avec la consigne de les réutiliser. Elle en crée beaucoup moins en double.
- Décrire ce qui ne se dessine pas. Les comportements entre deux tailles, les contenus limites, les états rares : quelques lignes dans la description du composant suffisent.
Ce que cela change pour les développeurs
Je n'apporte plus une image à interpréter. J'apporte une base qui fonctionne, construite sur les mêmes variables et les mêmes composants que le fichier. La discussion avec les développeurs ne porte plus sur « est-ce que ça ressemble », mais sur « est-ce que c'est bien construit ».
Cela ne les remplace pas. L'architecture, les données, la performance réelle restent leur domaine. Mais l'écart entre la maquette et le produit, qui coûtait des allers-retours sans fin, se réduit dès le départ.
En résumé
L'IA traduit fidèlement ce qu'un fichier dit, et invente ce qu'il ne dit pas. Tout le travail consiste à faire dire au fichier le plus de choses possible, puis à vérifier ce qui reste par des contrôles plutôt que par la confiance.